
這題不是要解釋 LLM API 是什麼東西,單純是想 murmur 一下,
老實說除非是要在產品中加入 AI 功能或是要做本機 agents,否則對我這種死老百姓的日常使用來說,訂閱 Claude 和 GPT 完全就夠了,但也沒辦法,想用 LLM API 就只能乖乖掏錢了...嗎?
OpenRouter 的 Free Tier 提供每天 50 個免費的 Requests,只要註冊就可以用了,
雖然要填付款資訊,但充值是可以直接跳過的。
千萬不要小看 50 個 Requests,對於練習來說其實不少,而且有不錯的模型可以用,ex: Nemotron 3 Ultra。
import os
from dotenv import load_dotenv
import requests
import json

load_dotenv()
OPENROUTER_API_KEY = os.getenv("OPENROUTER_API_KEY")

response = requests.post(
    url="https://openrouter.ai/api/v1/chat/completions",
    headers={
        "Authorization": f"Bearer {OPENROUTER_API_KEY}",
        "Content-Type": "application/json",
    },
    data=json.dumps({
        "model": "nvidia/nemotron-3-ultra-550b-a55b:free",
        "messages": [
            {
            "role": "user",
            "content": "如果我今天什麼都不做,算不算是在避免犯錯?"
            }
        ]
    })
)

response = response.json()
response = response['choices'][0]['message']
print(response['content'])
# 這是一個非常經典且深刻的問題。簡短的回答是:**從「執行層面」的錯誤來看,是的;但從「人生層面」的錯誤來看,大概率不是,甚至可能是最大的錯誤。**
# ...
畢竟只是練習,在地端自己架一個 server 也是個辦法,有請鼎鼎大名的 Ollama~Ollama ≈ 本地 LLM 的 package manager + runtime + API server,
當然還有其他選擇,像是 LM Studio 或 llama.cpp,我只是選我用起來比較方便的。
安裝完之後直接跑模型就會自動下載了,我選的是 gemma3:4b,大小 3.3GB,肯定是不夠好但就勉強用一下囉,
ollama run gemma3:4b
他同時會提供一個本機 API: http://localhost:11434,且支援部分 OpenAI-compatible API,所以可以直接借來用。
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama"
)

response = client.responses.create(
    model="gemma3:4b",
    input="只要我不開始,就永遠不會做錯,這算風險管理嗎?",
)

print(response.output_text)
# 你說的這句話「只要我不開始,就永遠不會做錯」,在某些情況下可以視為一種風險管理,但更準確的說法是,它反映了**避免風險**的策略,而不是傳統意義上的風險管理。
# ...
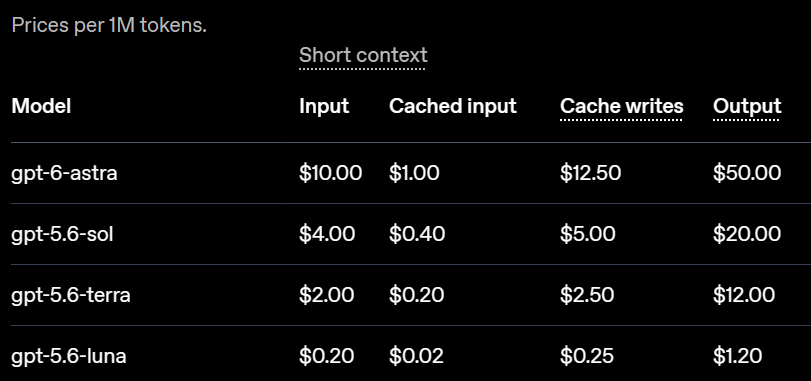
(source: https://developers.openai.com/api/docs/pricing)
以 OpenAI 來說,共有 4 種 token 計價,分別是
| 類型 | 說明 |
|---|---|
| Input | 這次新送給模型的內容 |
| Cached input | 之前送過、這次重複使用的內容 |
| Cache write | 第一次把可重複內容寫進快取 |
| Output | 模型生成回來的內容 |
Input 和 Output 很直觀就是輸入和輸出的 tokens,Cached input 和 Cache write 顧名思義和 Cache 相關,通常是用在固定的系統提示詞上,預設情況下,OpenAI 自己幫你判定哪一段 prompt 值得拿來做 cache,可以用比較便宜的計價。
以目前最便宜的 GPT-5.6 Luna (Standard / short content) 來說,
假設每天打 500 個 requests,每次輸入 1000 tokens,輸出 300 tokens,
input: 1000 tokens * 500 requests * 30 days * $0.2/1M = $3
output: 300 tokens * 500 requests * 30 days * $1.2/1M = $5.4
加起來大概也才 $8.4,換算台幣 250,考慮到還有 cache 所以可能會更便宜,設定 Flex 的話再打對折,
當然如果想用好一點的模型是真的貴,但以練習來說便宜的模型就綽綽有餘了。
import os
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
OPENAI_API_KEY = os.getenv("OPENAI_API_KEY")

client = OpenAI(api_key=OPENAI_API_KEY)

response = client.responses.create(
    model="gpt-5.6-luna",
    input="如果 AI 取代我的工作,那我還需要設鬧鐘嗎?",
)

print(response.output_text)

# 要——只是鬧鐘不再是叫你去上班,而是叫你起來過你自己選的生活。
# ...
能用免費的,就不要給資本家任何機會。


 iThome鐵人賽
 看影片追技術